|
2026.07.30 (수정 : 2026.08.04)
|
||
|
03 토큰 이코노미시대의 AI 핀옵스 전략 │윤대균 아주대학교
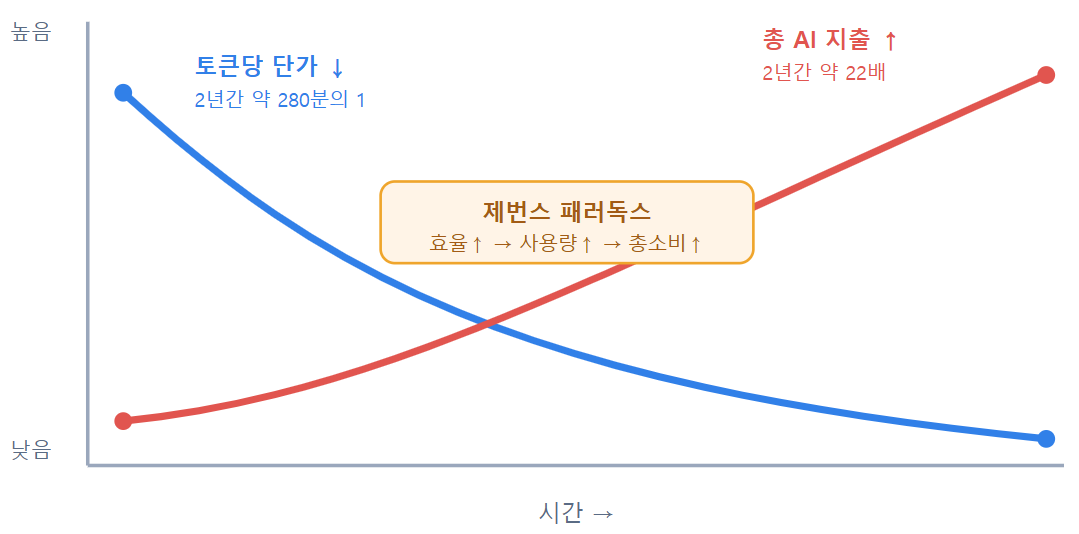
1. 들어가며 추론 단가는 급격히 떨어지고 있지만 기업의 AI 비용은 오히려 급증하고 있다. 생성형 AI가 POC단계를 지나 이제 본격적인 활용 단계로 넘어가면서, AI 모델을 실제 업무에 사용하기 위한 “추론”이 상시 업무에 필요한 대표적인 워크로드로 자리 잡았다. 그 결과 일부 기업은 AI 사용료로 월 수천만 달러 규모의 청구서를 받기 시작했다. 토큰당 단가가 내려가면 총비용도 내려가리라는 것이 상식이지만, 현실은 반대로 움직인다. 단가 하락 속도보다 사용량 증가 속도가 더 빠르기 때문이다. 자원의 사용 효율이 높아질수록 오히려 총소비가 늘어난다는 제번스 패러독스(Jevons paradox)가 AI 추론에서 그대로 재현되고 있다. 동일한 성능을 기준으로 보면 추론 단가는 연 수십 배 속도로 하락하고 있다. AI 연구기관 에포크 AI(Epoch AI)는 6개 벤치마크에서 특정 성능 수준에 도달하는 데 필요한 최저 단가가 얼마나 빨리 떨어졌는지를 측정했다. 그 결과 하락 속도는 성능 구간에 따라 연 9배에서 900배까지 편차가 컸고, 중앙값은 연 50배였다. 예를 들어 박사급 과학 문제(GPQA Diamond)에서 GPT-4 수준의 성능에 도달하는 단가는 연 40분의1로 떨어졌다.1) 여기서 말하는 성능 구간이란 특정 난이도의 과제를 특정 품질 이상으로 풀어내는 능력 수준을 뜻한다. 벤치마크마다 목표 점수를 정해 두고, 그 점수 이상을 내는 가장 저렴한 모델의 단가를 추적/분석하는 방식이다. 낮은 성능 구간은 요약이나 분류처럼 비교적 쉬운 과제에 해당하며, 이미 값싼 소형 모델로도 충분히 도달할 수 있어 단가가 이미 바닥에 가깝다. 반면 높은 성능 구간은 박사급 과학이나 고급 수학처럼 어려운 과제에 해당하며, 최근까지도 고가의 최신 모델이라야 도달할 수 있었으나 그만큼 하락 여지가 커서 지금도 빠르게 값이 떨어지고 있다. 추론 비용을 이해하는 기본 단위는 토큰이다. 토큰은 모델이 처리하는 언어의 최소 조각으로, 입력 토큰과 출력 토큰으로 나뉜다. 상용 대규모 언어모델(LLM)의 가격은 통상 100만 토큰당 비용(CPM)으로 표시된다. 서로 다른 하드웨어와 처리량을 하나의 비교 가능한 숫자로 환산해 주기 때문에, CPM은 추론 경제를 가늠하는 표준 지표로 자리 잡았다. 2. 토큰 이코노미와 추론 비용의 역설 토큰 이코노미란 AI 서비스의 소비량과 원가가 토큰으로 계량되는 경제 구조를 뜻한다. 전력 사용량이 킬로와트시로 계량되고 그만큼 요금이 매겨지듯, AI에서는 입력과 출력이 모두 토큰으로 계량되고 토큰 수에 단가를 곱해 요금이 매겨진다. 사용자가 던진 프롬프트는 입력 토큰으로, 모델이 내놓은 응답은 출력 토큰으로 환산되며, 둘의 합에 단가를 곱한 값이 청구액이 된다. 따라서 어떤 기능이 소비하는 토큰량은 곧 그 기능의 원가이며, 서비스 기획자와 경영자는 토큰 소비를 매출과 이익 구조에 연동해 관리해야 한다. 토큰 이코노미에는 두 가지 구조적 특성이 있다. 첫째, 모델이 한 번에 처리할 수 있는 토큰 수인 컨텍스트 창이 유한하다. 컨텍스트는 무한히 늘릴 수 있는 공간이 아니라 값이 매겨진 희소 자원이다. 창을 채울수록 입력 토큰 비용이 늘고, 어텐션 연산량은 토큰 수의 제곱에 비례해 커지며, 너무 길어지면 중요한 정보가 묻혀 오히려 응답 품질이 떨어진다. 따라서 컨텍스트에 무엇을 담을지 자체가 비용과 품질을 좌우하는 설계 문제가 된다. 둘째, 같은 의미에도 불구하고 언어에 따라 토큰 수가 다른 다국어 토큰화 격차가 존재한다. 한국어는 같은 내용을 표현하는 데 영어보다 많은 토큰을 소비한다. 측정에 따르면 한국어는 동일한 정보를 담는 데 영어의 약 2.4배에 이르는 토큰을 쓰며, 이 때문에 토큰당 과금 서비스에서 한국어 사용자는 영어 대비 1.5배에서 2배가량 비용을 더 부담한다.2) 조사와 어미가 겹겹이 붙는 한국어의 교착어 특성이 영어 중심 토크나이저에는 최적화되어있지 않기 때문이다. 이 구조에서 단가가 내려가도 총비용이 늘어나는 이유는 사용량이 단가 하락보다 훨씬 빠르게 증가하기 때문이다. 이것이 추론 경제의 핵심 역설이다. 새로운 성능 구간이 저렴해질 때마다 그 가격에서 비로소 가격대비 쓸만한 새로운 활용 사례가 열리고, 그 사례들이 다시 토큰 소비를 늘린다. 가격이 내려간 만큼, 혹은 그 이상으로 수요가 팽창하는 구조다. 기업의 실제 지출 데이터가 이를 뒷받침한다. 멘로 벤처스(Menlo Ventures)의 조사에 따르면 기업의 생성형 AI 지출은 2023년 17억 달러에서 2024년 115억 달러, 2025년 370억 달러로 늘었다. 한 해 만에 3.2배, 2년 만에 약 22배로 커진 것이다.3) 토큰당 단가가 90% 넘게 떨어지는 동안 총지출은 오히려 수십 배로 불어났다는 뜻이다. 전체 시장으로 보면 가트너는 2026년 전 세계 AI 지출이 전년 대비 44% 늘어난 2조 5,200억 달러에 이를 것으로 전망한다.4) 그림은 단가와 총비용이 반대 방향으로 움직이는 이 역설을 요약한 것이다.
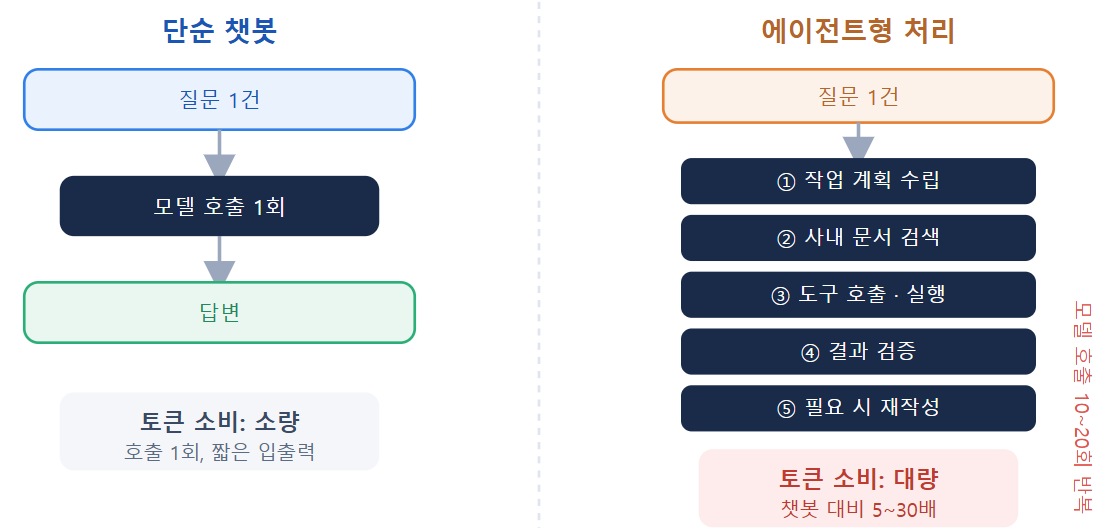
그림 1 추론 비용의 역설 수요 폭증을 이끄는 주요 요인은 추론특화 모델과 에이전트다. 여기서 “추론특화 모델”이라 함은 답을 내기 전에 내부적으로 단계적 사고 과정을 길게 생성하는 모델을 말한다. 답을 내기 전에 문제를 쪼개고 중간 계산을 거치며 스스로 점검하는 과정을 밟는다. 그 덕에 수학이나 코딩, 논리 추론처럼 어려운 과제에서 정확도가 크게 높아진다. 대신 그 중간 사고 과정에서 토큰을 대량으로 소비하기 때문에 비용이 훨씬 커진다. 요컨대 간단한 요약이나 문의 응대는 즉답형 모델로 충분하지만, 복잡한 분석은 추론특화 모델이 유리하며, 그 대가는 대량의 토큰 소비이다. 에이전트는 여기서 한 걸음 더 나아간다. 자율적으로 작업을 분해하고 도구를 호출하며 결과를 검증하고 스스로 교정하는 과정에서, 하나의 사용자 요청이 수십 번의 모델 호출로 확장되기도 한다. 에이전트형 워크로드가 일반 챗봇 대비 작업당 5배에서 25배 더 많은 비용을 소요한다는 분석도 나와 있다.5) 그림 2에서 볼 수 있듯이 과거의 챗봇 스타일에서는 질문 1건에 모델 호출 한 번으로 짧게 답했다면, 에이전트형 처리 방식에서는 질문을 여러 하위 작업으로 나누고, 사내 문서를 검색하며, 답의 정확성을 스스로 검증하고, 필요하면 재작성한다. 이를 위해 내부에서는 열 번 이상의 모델 호출과 수만 개의 토큰이 소모된다. 응답 품질은 분명히 높아지지만 질문 건당 원가도 그만큼 커진다는 뜻이다. 결국 에이전트 워크플로우를 어떻게 설계하고 통제하느냐에 따라 총비용이 결정되며, 이를 최적화하기 위한 전략적 접근이 필요하다. 이를 AI 핀옵스 관점에서 살펴보자.
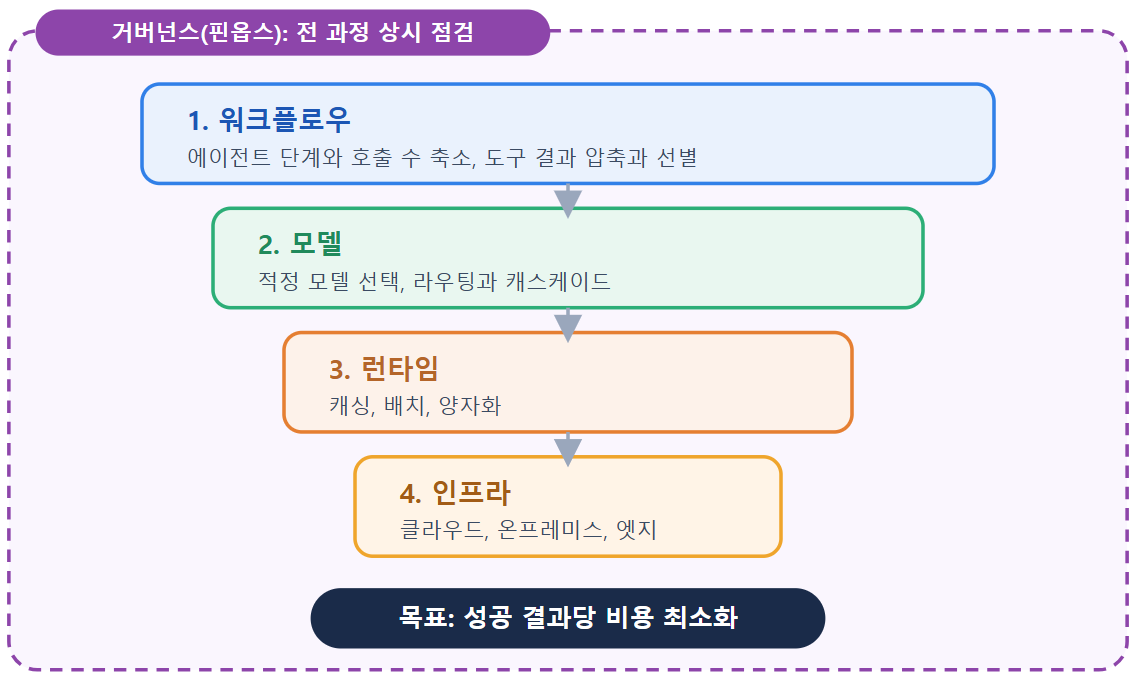
그림 2 같은 질문, 다른 토큰 소비 3. 추론 경제의 운영: AI 핀옵스 추론 비용의 최적화는 설계 단계에서부터 적절한 거버넌스하에 이루어져야 한다. 우선 비용을 측정하는 기준부터 바꿔야 한다. 토큰당 단가는 물론 필요하지만 이것만으로는 충분하지 않다. 최선의 결과를 추구한다는 명목으로 최신 모델을 기본값으로 두고, 추론 강도를 최고로 설정하거나, 또는 문맥 창을 크게 잡는 것은 모두 값비싼 청구서로 귀결된다. 올바른 목표는 토큰당 비용이 아니라 "필요한 품질과 지연, 위험 수준에서 성공적 결과 하나를 얻는 데 드는 비용"이어야 한다.6) 비용 최적화를 위해서는 비용 구조를 워크플로우, 모델, 런타임, 인프라의 네 계층으로 구분하여 각 계층별 거버넌스, 즉 핀옵스로 전 과정을 상시 점검해야 한다(그림 3). 워크플로우 계층에서 불필요한 호출을 걷어내고, 모델 계층에서 적정 모델을 고르며, 런타임 계층에서 실행 효율을 높이고, 인프라 계층에서 계산 자원을 알맞게 배치하는 구조다. 상위 계층일수록 영향을 받는 대상이 크므로 절감 폭도 크다. 다만 상위 계층일수록 재설계 난이도와 그에 따른 품질 변화 위험이 크기 때문에 거버넌스 실행시 적용 순서는 성과 대비 노력을 함께 고려해야 할 것이다. 각 계층에 대해 조금 더 들여다보겠다. 그림 3 추론 비용 최적화의 4계층 3.1 워크플로우 계층: 에이전트와 도구 호출 최적화 워크플로우 계층은 가장 상위이자 레버리지가 가장 큰 최적화 지점이다. 거버넌스의 출발점은 과제에 정말 에이전트가 필요한지 되묻는 것이다. 단순 조회나 요약같은 작업은 자율 반복 없이 단일 호출로 처리하고, 에이전트를 쓰더라도 불필요한 반복 루프를 없애고 조기 종료 조건을 두어 호출 수와 단계를 줄인다. 도구 호출이 만들어 내는 컨텍스트 팽창을 관리하는 것도 핵심이다. MCP처럼 외부 도구를 붙이면, 데이터베이스 조회나 검색 결과가 통째로 컨텍스트에 쌓여 토큰 소비가 급증한다. 도구가 돌려준 결과에서 의미 있는 필드만 추리거나 요약해 다음 단계로 넘기고, 필요할 때만 상세 정보를 다시 불러오는 방식의 설계가 필요하다. 특히 긴 대화나 멀티 에이전트 구조에서는 컨텍스트 관리 자체가 최적화의 핵심이다. 앤스로픽은 에이전트 협업 시 '컨텍스트 엔지니어링'의 중요성을 강조한다. 예컨대 전체 맥락을 통째로 주고받는 대신 하위 작업을 서브 에이전트에 위임하고, 에이전트 간에는 핵심 요약만 전달하며, 오래된 맥락은 자동 요약(Compaction)하여 토큰 낭비를 막는 식이다.7) 최근 많은 관심을 받고 있는 하네스 엔지니어링도 워크플로우 최적화 관점에서 재조명해 볼 필요가 있다. 하네스는 실행 루프와 도구 호출, 컨텍스트 관리, 메모리, 가드레일을 묶어 모델을 실제 원하는 방향으로 작동하는 에이전트로 만드는 역할을 한다. 하네스 엔지니어링은 주로 결과의 품질과 신뢰성을 높이려는 흐름에서 각광받고 있지만, 토큰 이코노미 관점의 워크플로우 최적화와 사실상 같은 설계 표면에 있다. 하네스를 어떻게 설계하느냐가 곧 토큰 경제를 좌우한다고 보아도 과언이 아니다. 검증 루프나 다중 후보 생성처럼 품질을 위해 토큰을 더 쓸 경우에 이에 대한 정당성을 확보하는 것도 어떻게 보면 설계 단계에서 거버넌스 행위에 해당한다고 볼 수 있다. 즉 훌륭한 하네스 엔지니어링은 토큰을 사후 정산해야 할 '소모 비용'이 아니라, 시스템 설계 초기부터 최적화하고 통제해야 할 '핵심 자본'으로 다루는 것이다. 3.2 모델 계층: 적정 모델 선택과 라우팅 모델 계층의 원칙은 모든 요청에 최고 성능 모델을 쓰지 않는 것이다. 과제 난이도에 맞는 가장 값싼 모델을 고르는 것이 출발점이다. 이를 자동화한 기술이 모델 라우팅과 캐스케이드(cascade)다. 라우팅은 들어온 질의를 그것을 제대로 처리할 수 있는 가장 저렴한 모델로 보내는 방식이고, 캐스케이드는 우선 소형 모델이 처리해 보고 확신이 낮을 때만 대형 모델로 승급시키는 방식이다. 승급 여부는 소형 모델이 내놓은 답의 불확실성, 즉 토큰 확률 분포가 얼마나 한쪽에 몰려 있는지를 근거로 판단한다. 적절한 라우팅을 통해 최고 모델 품질의 95%를 유지하면서 질의의 85%를 값싼 모델로 처리해, 워크로드에 따라 45%에서 85%의 비용을 줄일 수 있다는 분석이 있다. 실제 운영 환경에서도 40%에서 70%의 절감이 흔히 보고된다.8) 더 나아가 모든 것을 GPU로 돌릴 필요는 없으며, 실제 가치를 내는 상당수 AI 워크로드는 범용 CPU로도 충분히 돌아간다고 지적하기도 한다. 과제 수준이나 규모 대비 과잉 자원을 걷어내는 것만으로도 큰 절감이 가능하다는 뜻이다. 3.3 런타임 계층: 캐싱과 서빙 최적화 런타임 계층에서는 같은 모델이라도 실행 방식을 바꿔 원가를 낮출 수 있다. 대표적으로 프롬프트 캐싱을 들 수 있다. 여러 요청에 공통으로 들어가는 시스템 프롬프트나 긴 문맥을 캐시에 저장해 두면, 매번 같은 입력을 새로 처리하지 않아도 된다. 앤스로픽은 캐시에서 읽는 입력 토큰에 90% 할인을 적용한다. 한 보안 기업은 캐시 적중률을 7%에서 84%로 끌어올려 전체 LLM 비용을 59%에서 70%까지 줄였는데, 이때 캐시에서 처리된 토큰만 98억 개에 이르렀다고 한다.9) 서빙 엔진 차원의 최적화도 효과가 크다. 연속 배치(continuous batching)는 먼저 끝난 요청 자리에 새 요청을 곧바로 채워 GPU를 놀리지 않게 하고, 양자화는 모델 가중치를 FP8이나 INT8 같은 저정밀 형식으로 바꿔 메모리와 연산을 아낀다. 추론적 디코딩(speculative decoding)은 작고 빠른 초안 모델이 다음 토큰을 미리 추측하고, 본 모델이 한 번에 검증하게 해 생성 속도를 높인다. 이런 방식으로 처리량이 많아지면 같은 하드웨어로 더 많은 토큰을 처리하므로 토큰당 원가가 내려간다. 3.4 인프라 계층: 클라우드와 온프레미스의 조합 인프라 계층에서는 워크로드 특성에 맞는 연산 자원을 선택하는 것이 중요하다. 변동성이 크거나 실험 성격이 강한 워크로드, 최신 모델을 빠르게 써야 하는 경우에는 퍼블릭 클라우드가 유리하다. 반면 대량으로 상시 반복되는 운영 추론은 온프레미스, 저지연이 중요한 처리는 엣지가 적합하다. 이에 많은 기업이 하나의 플랫폼에 몰아넣는 대신 워크로드마다 최적 플랫폼을 조합하는 하이브리드 컴퓨트 포트폴리오로 옮겨가고 있다. 최적의 하이브리드 조합을 위한 자동화 도구도 점차 확대되는 추세다. 이런 도구가 확산되면서 인프라 조달은 주기적이고 수작업에 의존하던 방식에서 상시적이고 알고리듬에 기반한 방식으로 이동하고 있다. 워크로드 수요와 비용 변동, 성능 요구를 실시간으로 반영해 모델과 인스턴스를 동적으로 배분하는 단계로 나아가는 것이다. 이는 기존 클라우드 네이티브 컴퓨팅 패러다임이 AI 연산 최적화를 지원하는 형태로 빠르게 진화하고 있음을 시사한다. 3.5 거버넌스 계층: 핀옵스와 아키텍처 규율 앞의 네 계층이 제대로 작동하려면 비용 가시성이 전제되어야 한다. 어떤 팀과 기능, 어떤 모델이 토큰을 얼마나 소비하는지 분해해 볼 수 없으면 최적화 대상을 특정할 수 없다. 클라우드 인프라 지출을 부서나 프로젝트 단위로 할당하고 정산해 온 전통적 핀옵스처럼 AI 워크로드도 호출 단위로 소비 토큰과 비용을 기록하고 서비스와 기능별로 귀속시키는 측정 체계가 먼저 갖춰져야 한다. 학습 비용과는 달리 추론 비용은 예측이 어렵고 빠르게 변화하므로 주 단위 혹은 그보다 작은 단위의 지속적 점검으로 이상 급증을 조기에 잡아야 한다. 거버넌스는 조직 구조로도 내재화 되어야 한다. 아키텍처 리뷰 보드를 두어 신규 AI 프로젝트가 비용과 성능, 거버넌스, 위험 요소 등의 판단 기준에 따라 적정 인프라 위에서 돌아가는지 심사한다. 어떤 과제는 외부 API 호출로, 어떤 과제는 온프레미스 자원으로 처리하도록 초기부터 규율하는 것이다. 이런 흐름을 따라가기 위해서는 조직의 구성원이 추론 경제와 하이브리드 원가 구조를 이해할 수 있는 역량을 갖추어야 한다. 4. 시사점 추론 경제에서의 절대 금기 사항은 단가 하락이 비용 절감으로 이어질 것이라는 막연한 기대감이다. 토큰당 가격이 떨어질 것을 전제로 AI 예산을 짜는 것은 매우 위험한 시나리오다. 사용량이 단가보다 빠르게 늘어나는 한 총비용은 계속 증가한다. 값싼 추론은 더 많은 활용을 부르고, 더 많은 활용은 더 큰 청구서로 돌아온다. 첫째 과제는 토큰을 원가의 기본 지표로 삼는 운영 체계를 구축하는 것이다. 서비스 기획부터 운영까지 모든 단계에서 소비하는 토큰량을 원가로 인식하고, 결과당 비용을 표준 성과지표로 삼아야 한다. 둘째 과제는 비용 거버넌스를 설계 단계에 내재화하는 것이다. 어떤 모델을 어떤 인프라에서 어떤 강도로 돌릴지를 초기부터 규율하는 아키텍처 심사 체계가 필요하다. 셋째 과제는 컴퓨트 배치의 유연성 확보다. 모든 워크로드를 클라우드나 GPU에 몰아넣는 대신 클라우드와 온프레미스, 엣지를 워크로드 특성에 맞게 조합하는 하이브리드 전략이 원가 경쟁력을 좌우한다. 국내 기업과 공공부문에도 시사하는 바가 크다. 생성형 AI활용을 본격적으로 확산하는 국면에서 추론 비용을 체계적으로 관리하는 운영 역량은 우선순위에서 다소 밀려나 있다. 도입 초기부터 토큰 기반 원가 관리와 핀옵스 체계를 함께 세운다면, 뒤늦게 폭증하는 비용에 대응함으로써 맞닥뜨릴 문제를 최소화할 수 있다. 특히 데이터 주권이나 규제 대응이 중요한 공공과 금융 영역에서는 온프레미스와 소버린 클라우드가 비용과 통제를 동시에 잡는 현실적 선택지가 될 수 있다. 추론 단가가 저렴해질수록 이를 얼마나 규율 있게 쓰느냐가 조직의 AI 경쟁력을 가르게 될 것이다. 참고문헌 1) Ben Cottier et al., “LLM inference prices have fallen rapidly but unequally across tasks”, Epoch AI, Mar. 2025 2) Anthony Shaw, “Working with Chinese, Japanese, and Korean text in Generative AI pipelines”, Mar 12, 2024 3) Menlo Ventures, “2025: The State of Generative AI in the Enterprise”, Dec. 09, 2025. 4) Gartner, “Gartner Says Worldwide AI Spending Will Total $2.5 Trillion in 2026”, Jan. 15, 2026 5) TechAhead, “The Inference Cost Trap: Why Your AI Agent Economics Break At Scale”, Jun 8, 2026 6) Spheron, “AI Inference Cost Economics in 2026: GPU FinOps Playbook”, Apr 4, 2026. 7) Anthropic, “Effective context engineering for AI agents”, Sep 29, 2025 8) LeanLM, “LLM Model Routing: Automatically Send Every Query to the Cheapest Capable Model”, May, 2026 9) ProjectDiscovery, “How We Cut LLM Costs by 59% With Prompt Caching”, Apr 10, 2026
이슈리포트_2026-07호.pdf (1 MB)
|
||