|
2026.08.31 (수정 : 2026.09.02)
|
||||||||||||||||||||||||||
|
03 모델이 곧 컴퓨터다: AMD의 탈라스 인수와 모델 특화 반도체 │윤대균 아주대학교 소프트웨어학과
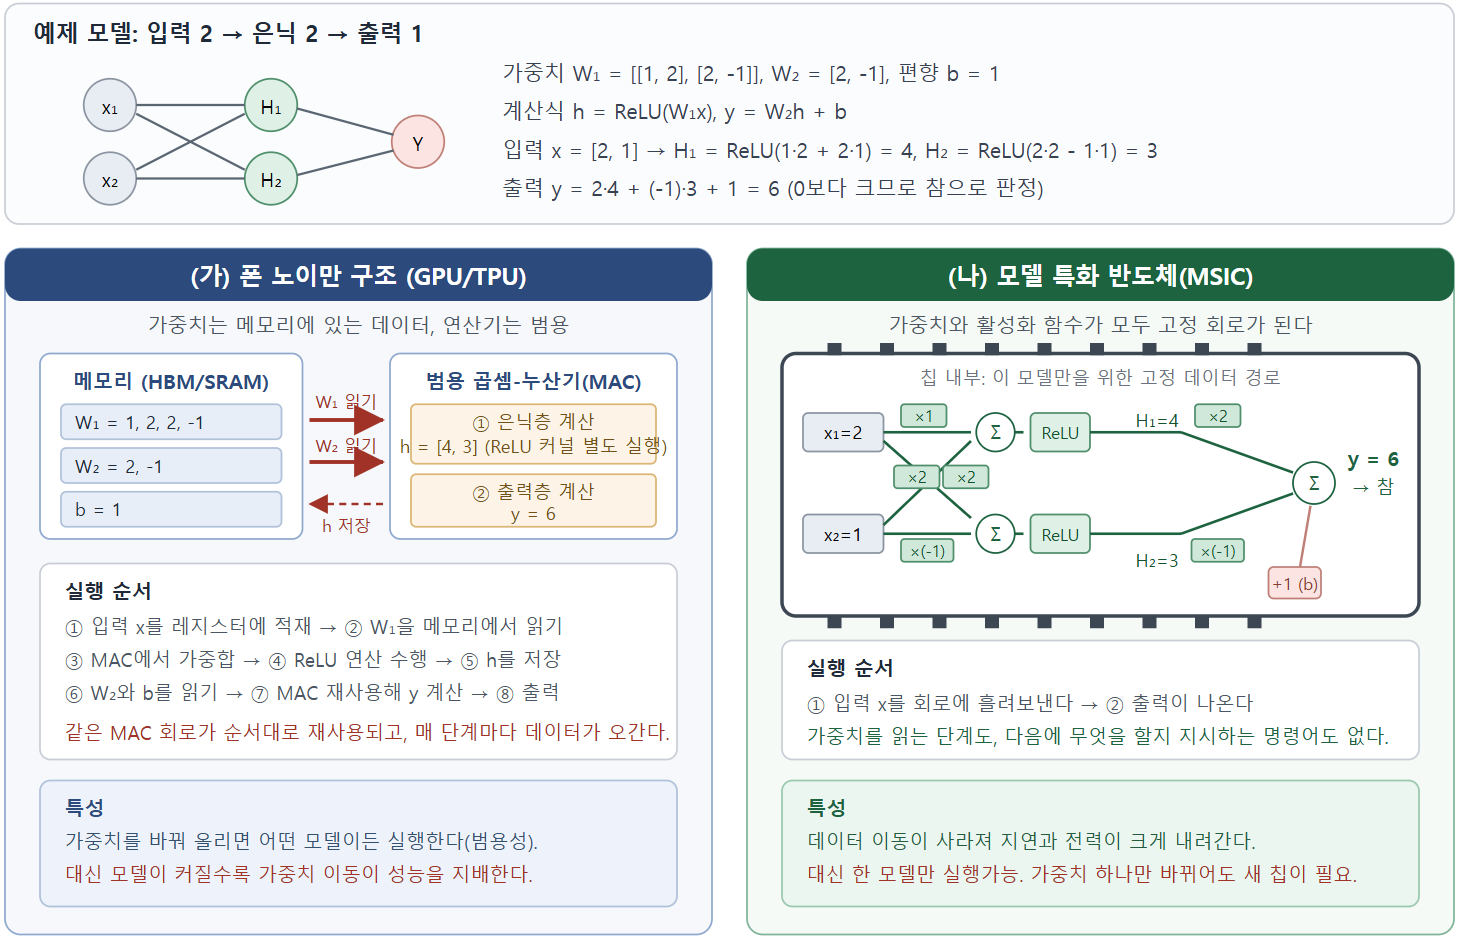
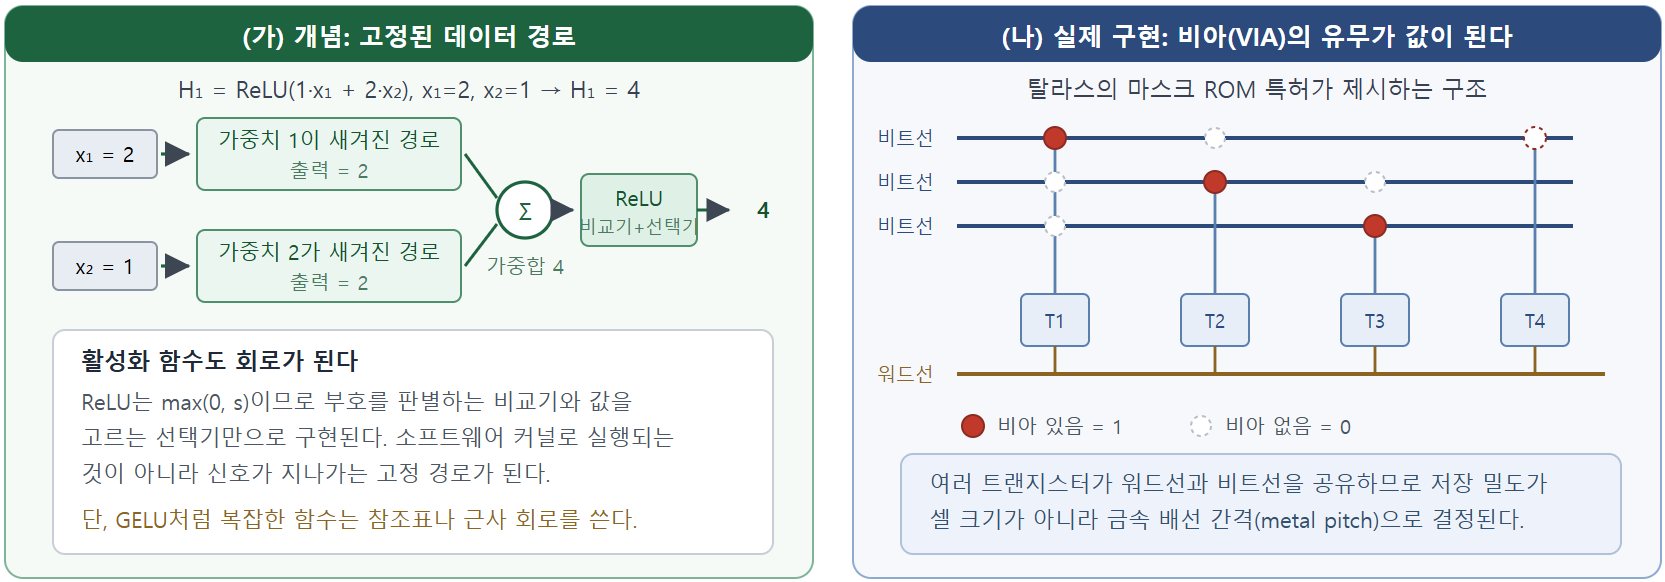
1. 들어가며 AMD가 2026년 8월 6일 캐나다 토론토의 반도체 스타트업 탈라스(Taalas) 인수 계약을 발표했다.1) 탈라스는 2023년 설립된 직원 25명 규모의 회사로, AI 모델의 가중치를 반도체 회로에 직접 새겨 넣는 방식의 추론 전용 칩을 개발한다. AMD는 인수 사유로 범용 아키텍처가 가진 연산과 메모리의 병목을 줄이는 탈라스의 추론 데이터 흐름 기술을 들었고, 이를 자사의 인스팅트(Instinct) GPU와 결합한 시스템 개발에 활용한다고 밝혔다. 최근 9개월 사이 AMD가 진행한 세 번째 AI 관련 인수이며, 2025년 12월 엔비디아가 그록(Groq)의 자산을 약 200억 달러에 확보한 데 이어, 추론 전용 하드웨어를 둘러싼 경쟁이 본격화하는 양상이다.2) 탈라스가 만드는 것은 통상의 AI 가속기와 범주가 다르다. 일반적인 GPU나 신경망 처리장치(NPU)는 어떤 모델이든 가중치를 메모리에 올려 실행하는 범용 장치인 반면, 탈라스의 칩은 특정 모델 하나만 실행하는 일종의 ASIC이다. 모델의 가중치와 데이터 흐름이 칩 제조 단계에서 회로로 고정되기 때문에 좀 더 구체적으로는 모델 특화 반도체(MSIC: model-specific integrated circuit)이다.3) 본 글의 제목에 들어있는 "모델이 곧 컴퓨터다(The Model is The Computer)"는 탈라스 홈페이지에 걸린 슬로건이기도 하다. 가중치를 회로에 새긴다는 착상 자체는 ASIC을 설계하는 관점에서 완전히 새로운 개념이라고는 볼 수 없다. 사실 진짜 어려운 문제는 이를 수백억 파라미터 규모의 실제 모델에 적용해 제조할 수 있고, 추론을 제대로 돌릴 수 있으며, 추후 모델이 바뀔 경우 “경제적으로” 새로 만들 수 있느냐이다. 이 글에서는 아주 작은 신경망을 예로 들어 MSIC의 동작 원리를 폰 노이만 구조와 대비하여 설명하고, 이어 실제 모델 규모로 확장할 때 부딪히는 과제와 이를 탈라스는 어떻게 해결하는지 살펴보고자 한다. 2. MSIC의 동작 원리 2.1 아주 작은 신경망으로 보는 두 가지 실행 방식 입력 두 개와 은닉 노드 두 개, 출력 하나로 이루어진 최소한의 신경망을 생각해 보자. <그림 1> 은닉층 가중치를 W₁ = [[1, 2], [2, −1]], 출력층 가중치를 W₂ = [2, −1], 편향을 b = 1이라 하고, 활성화 함수로 ReLU를 쓴다. 입력 x = [2, 1]을 넣으면 은닉 노드는 H₁ = ReLU(1·2 + 2·1) = 4, H₂ = ReLU(2·2 − 1·1) = 3이 되고, 최종 출력은 y = 2·4 + (−1)·3 + 1 = 6이다. 가중치는 모두 여섯 개, 곱셈은 여섯 번으로 끝난다. 폰 노이만 구조를 따르는 GPU나 TPU는 이 계산을 여러 단계로 나누어 수행한다. 여섯 개의 가중치를 메모리에 데이터로 저장해 두고, 곱셈-누산기(MAC: multiply-accumulate)가 필요할 때마다 값을 읽어와 곱하고 더한다. 은닉층 계산을 마치면 중간 결과를 저장하고 ReLU 연산을 따로 실행한 뒤, 다시 출력층 가중치를 읽어 와 같은 MAC 회로를 재사용한다. 연산기는 어떤 값이든 처리할 수 있는 범용 회로이고, 가중치는 그 회로의 입력값으로 들어간다. 그래서 동일한 하드웨어에 가중치만 바꿔 입력하면 전혀 다른 신경망을 실행할 수 있다. MSIC는 다른 방식으로 접근한다. 여섯 개의 가중치마다 그 값을 곱하는 회로를 하나씩 실제로 만들어 두고, 노드 사이의 연결도 물리적 배선으로 고정한다. 가중치 2를 곱하는 자리에는 2만 곱하는 회로가 놓인다. 가중치를 읽어 오는 동작이나, 다음에 실행할 명령어도 따로 지정할 필요가 없다. 입력 신호를 넣으면 회로를 타고 흐르면서 계산이 끝난다. 폰 노이만 구조에서 가중치를 오가게 하는 입출력과 명령어를 인출하고 해독하는 과정이, MSIC에서는 신호가 고정된 회로를 따라 흐르는 것으로 갈음된다. 가중치가 상수로 고정되면 범용 곱셈회로 자체가 필요 없어진다는 점도 연산 가속화에 큰 이점이 된다. 예를 들어 곱하기 1은 그냥 배선만, 곱하기 2는 배선과 시프트, 곱하기 -1은 부호 반전, 이런 성질을 활용하면 임의 상수도 시프트-덧셈으로 축약되고, ‘0’ 가중치는 회로가 아예 통째로 사라진다. 그림 1 신경망을 실행하는 방식 비교 2.2 가중치가 ‘실리콘에 내장’된다는 말의 의미 은닉 노드 H₁ 하나를 확대해 보면 가중합 경로와 합산기, 그 뒤의 활성화 함수까지 모두 하드웨어 경로에 담겨 있다. ReLU는 max(0, s)이므로 입력의 부호를 판별하는 비교기(comparator)와 값을 고르는 선택기(multiplexer)만으로 구현된다.4) GPU에서는 코드 한 줄로 실행되는 함수가 MSIC에서는 신호가 지나가는 고정된 회로 블록이 되는 것이다. 다만 GELU(가우시안 오차 선형 유닛)처럼 좀 더 복잡한 함수는 그대로 회로화하기 어려워 참조표(LUT: lookup table)나 구간별 선형 근사를 쓴다. 요컨대 가중치와 가중합, 활성화 함수, 데이터 흐름 전체가 하드웨어로 내려간다. 그림 2 은닉노드를 확대해 추상화한 개념(가) 및 실제 비아 패턴을 이용한 구현(나) <그림 2>의 (가)에서 "×2 회로"는 설명을 위한 추상화다. 실제로 가중치 하나마다 독립된 곱셈기를 배치하면 배선이 너무 복잡해 칩을 만들 수 없다. (나)처럼 배선을 공유하고 비아(via) 패턴만으로 값을 표현하면, 배선 혼잡을 피하면서 밀도를 끌어올릴 수 있다. 실제 가중치가 회로에 어떻게 구현되는지는 뒤에서 좀 더 다룬다. 2.3 이렇게 특화해서 얻는 것은 무엇인가? 이런 특화를 시도하는 이유는 추론의 병목이 연산이 아니라 데이터 이동에 있기 때문이다. LLM이 토큰을 하나씩 만들어 내는 디코드 단계는 토큰 하나를 생성할 때마다 모델 가중치 전체를 메모리에서 다시 훑는다. 뒤에서 볼 탈라스 HC1의 대상 모델인 라마 3.1 8B를 예로 들어 보자. 학습에 흔히 쓰는 32비트 정밀도의 절반인 16비트로 파라미터 하나를 담는 형식을 반정밀도(FP16)라 하는데, 이 형식이면 파라미터 하나가 2바이트이므로 80억 개는 약 16기가바이트가 된다. 토큰 하나를 만들 때마다 이 16기가바이트가 통째로 읽힌다. 문제는 그렇게 읽어 온 데이터로 하는 일이 많지 않다는 데 있다. 가중치 하나를 읽어 곱하고 더하는 것이 전부이므로 연산량은 바이트당 한두 번이다. 그런데 H100의 두 가지 성능을 비교해 보면 상황이 드러난다. 메모리에서 데이터를 끌어오는 속도, 곧 메모리 대역폭은 초당 3.35테라바이트다. 반면 끌어온 데이터를 처리하는 연산 성능은 초당 약 990조 회에 이른다. 앞의 수치로 1바이트를 가져오는 동안 뒤의 수치로는 300회 가까이 연산할 수 있다는 뜻이다. 즉 연산기를 놀리지 않으려면 바이트당 300회는 계산할 거리가 있어야 하는데, 실제로 필요한 것은 한두 번뿐이다. 연산 능력의 대부분이 데이터를 기다리며 비어 있는 셈이다. 여기에 하나의 단서를 달아 두어야 한다. 이 계산은 요청을 하나만 처리할 때를 가정한다. 여러 요청을 묶어 한꺼번에 처리하면 한 번 읽어 온 가중치를 모든 요청이 나누어 씀으로 읽기 비용이 분산되고, 배치가 수백 개에 이르면 GPU는 대역폭이 아니라 연산이 병목인 영역으로 넘어간다. 따라서 GPU가 취약한 것은 총 처리량이 아니라 사용자 한 명이 체감하는 지연이다. 요청을 넉넉히 묶어 원가를 맞추는 구간에서 GPU는 여전히 효율적이며, 묶을 요청이 없거나 응답 지연이 곧 서비스 품질인 경우 메모리 벽이 바로 사용성 문제로 드러난다.5) HBM으로 이 벽을 낮출 수는 있지만 그 한계는 크게 벗어날 수는 없다. MSIC는 가중치가 회로 안에 새겨져 있어 읽어 올 대상이 없으므로 대역폭이라는 항이 식에서 사라지고, 남는 것은 신호가 회로를 통과하는 시간뿐이다. 탈라스가 같은 라마 3.1 8B를 담은 첫 칩에서 사용자 한 명 기준 초당 1만 6천 개가 넘는 토큰을 생성했다고 주장하는 근거가 여기에 있다.6) 앞의 H100 예에서의 210개와 견주면 80배에 가까운 값이다. 물론 이는 사용자 한 명의 경우다. 3. 실제 모델을 담기 위한 과제와 탈라스의 해법 여섯 개의 가중치를 회로로 새기는 일은 어렵지 않다. 문제는 80억 개를 새겨야 할 때 생긴다. 앞 장의 원리를 실제 모델 규모로 확장하려면 서로 얽힌 여러 과제를 동시에 풀어야 한다. 3.1 밀도의 벽: 저장, 연산, 배선을 하나로 합치다 첫 번째 벽은 저장 밀도다. 라마 3.1 8B의 80억 파라미터를 4비트로 담아도 4기가바이트에 이른다.7) 흔히 쓰는 온칩 메모리인 SRAM은 비트 하나를 담는 데 트랜지스터 여섯 개가 필요하므로, 4비트면 24개, 80억 파라미터면 트랜지스터 약 1,900억 개가 저장에 쓰인다. 위키피디아 자료에 의하면 최신 3나노 공정의 트랜지스터 밀도가 제곱밀리미터당 약 2억 개이다.8) 따라서 1,900억 개는 950제곱밀리미터가 필요한데, 이는 단일 칩(다이) 제조 한계인 레티클 한계(reticle limit) 약 858제곱밀리미터를 훌쩍 넘는다.9) SRAM은 디코더와 감지 증폭기 같은 주변 회로가 따라붙으므로 실제 면적은 이보다 커진다. 곱셈 회로는 제외했음에도 이 정도다. 탈라스는 마스크 ROM을 저장 수단으로 택했다. 저장할 내용이 제조용 포토마스크 단계에서 확정되는 읽기 전용 메모리다. 그중에서도 상위 배선과 하위 트랜지스터 셀 사이의 연결 통로인 비아 홀을 뚫거나 막는 방식으로 0과 1을 결정하는 쪽을 골랐다. 셀 구조가 단순해 같은 면적에 훨씬 많은 비트를 담을 수 있지만, 한 번 만들면 바꿀 수 없다. 두 번째 벽은 연산 회로의 통합이다. 일반 구조에서는 저장 소자와 읽기 회로, 곱셈기가 모두 따로 필요하다. 공동창업자 류비샤 바이치(Ljubisa Bajic)는 마스크 ROM 리콜 패브릭에서 4비트를 저장하고 그에 관련된 곱셈까지 트랜지스터 하나로 처리하는 방식을 찾았다고 밝혔다. 구체적 회로는 공개하지 않았다.10) 물론, 트랜지스터 하나로 처리한다는 것은 표현상 오해의 소지가 많다. 양자화된 가중치가 가질 수 있는 값이 몇 개뿐이므로(예를 들어 3비트면 8개), 입력 활성값에 대해 적은 수(3비트면 8번)의 곱셈을 미리 해 놓고 실제 은닉노드에서의 연산은 곱셈 연산 없이 곱셈 결과를 “선택”한 후 더하는 방식으로 이루어진다는 분석이 설득력이 있다.11) 세 번째 벽은 배선이다. 가중치 하나마다 배선과 연산 회로를 문자 그대로 배치하면 배선 혼잡 때문에 칩을 만들 수 없다. 칩은 맨 아래에 트랜지스터를 깔고 그 위로 금속 배선을 여러 층 쌓아 올린 구조이며, 최신 공정에서 이 금속층은 십수 개에 이른다. 층 사이는 절연막으로 막혀 있어 다른 층의 배선을 이으려면 절연막을 뚫고 금속을 채워야 한다. 이 수직 통로가 비아(via)다. 아래층을 공통으로 깔아 두고 비아 층의 패턴만 바꾸면 이미 만든 공정 대부분을 그대로 둔 채 기능을 다시 정의할 수 있고, 비아 층은 패턴이 단순해 마스크 제작 비용도 상대적으로 낮다. 탈라스가 2025년 4월 출원한 마스크 ROM 특허는 이 성질을 저장에 적용한 사례다. 한 열의 트랜지스터들이 워드선과 비트선을 공유하도록 배치하고, 비트선과 트랜지스터 사이에 비아를 두는지 여부로 값을 표현한다. 비아가 있으면 1, 없으면 0이다.12) 요컨대 탈라스가 푼 것은 저장과 연산, 배선을 각각 최적화한 것이 아니라 셋을 하나의 구조로 합친 것이다. <그림 3>의 (나)는 이 원리를 단순화한 것이다. 3.2 고정할 것과 변해야 할 것을 나누다 모든 것을 회로에 새길 수는 없다. 트랜스포머 추론에는 실행할 때마다 달라지는 데이터가 존재한다. 대표적인 것이 KV 캐시다. LLM은 이미 처리한 토큰의 키와 값 벡터를 저장해 두고 재사용하는데, 이 내용은 사용자의 대화마다 완전히 달라진다. 고객이 파운데이션 모델을 자기 데이터로 미세 조정하는 파인튜닝 역시 가중치의 변경을 전제한다. 따라서 "모델 전체를 ROM에 굽는다"는 표현은 엄밀하게는 맞지 않다. 탈라스는 칩을 두 영역으로 나누어 이 문제를 풀었다. 회사는 각각을 마스크 ROM 리콜 패브릭과 SRAM 리콜 패브릭이라 부른다. 전자에는 바뀌지 않는 기반 가중치와 고정된 데이터 흐름을 새기고, 후자에는 KV 캐시와 파인튜닝용 어댑터를 담는다. 어댑터란 기반 가중치는 그대로 두고 소량의 보정 가중치만 더해 모델의 거동을 바꾸는 파인튜닝 기법으로, 로라(LoRA)가 대표적이다. 탈라스의 또 다른 특허는 이 구분을 모델 코어와 파인튜닝 부분으로 명시하고, 앞쪽은 마스크 ROM에, 뒤쪽은 프로그래밍 가능한 메모리에 둔다고 기술한다.13) 이 분리가 이 구조의 핵심이다. 모델에서 거의 변하지 않는 대부분은 고정하고, 계속 변하는 작은 부분만 프로그래밍 가능하게 남긴다. 다만 이런 발상 자체가 최초는 아니고 이미 선례가 있다.14) 3.3 두 장의 마스크와 모델에서 실리콘까지의 자동화 탈라스의 접근 방식이 넘어야 할 가장 큰 허들은 경제성이다. 최신 공정의 마스크 세트 한 벌은 층이 100개를 넘고 비용도 수백만 달러에서 수천만 달러에 이른다. 통상의 전용 반도체 설계는 아키텍처 정의부터 회로 설계, 배치와 배선, 검증을 거쳐 제조에 들어가기까지 1년에서 2년이 걸리는데, 그 사이에 모델은 이미 수차례 바뀐다. LLM을 전용 칩으로 만들자는 발상이 그동안 현실적이지 않았던 이유가 이것이다. 탈라스의 해법은 2000년대에 등장했던 구조화 ASIC 개념을 되살린 것이다. 구조화 ASIC은 논리 회로의 기본 블록을 미리 만들어 두고 층 몇 개의 배선 패턴만 바꿔 용도를 정하는 방식으로, 이에이직(eASIC) 같은 회사가 상용화했다.15) 이에이직은 2018년 인텔이 인수해서 프로그래머블 솔루션 사업에 편입했다. 탈라스는 이 원리를 모델과 가중치, 데이터 흐름의 맞춤에 적용했다. 100여 개 층 가운데 두 개 층만 교체하면 다른 모델을 담을 수 있고, 이 두 층이 가중치와 데이터 흐름을 함께 결정한다. 나머지 층과 연산 회로, 클록과 전원, SRAM은 그대로 재사용하므로 NRE(non-recurring engineering)에 소요되는 비용과 기간이 크게 줄어든다. <그림 3>가 이 흐름을 정리한 것이다. 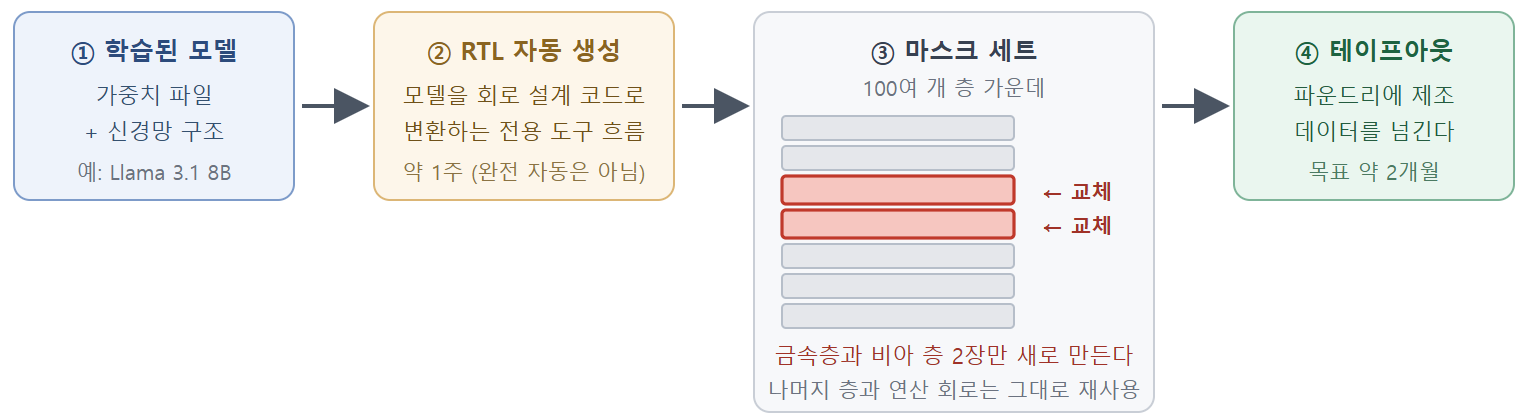 그림 3 모델에서 칩까지의 흐름 두 장의 패턴을 설계하는 데에도 여전히 여러 달이 걸린다. 그래서 모델 파일을 RTL(register transfer level) 코드로 바꾸는 자동화가 반드시 필요하다. 반도체 설계는 사양 정의, RTL 설계, 논리 합성, 배치와 배선, 검증, 테이프아웃의 순서로 진행되는데, RTL은 베릴로그(Verilog) 같은 하드웨어 기술 언어로 회로의 동작을 신호와 레지스터 사이의 데이터 이동으로 기술하는 단계이며, 소프트웨어의 소스 코드에 해당한다. 이후 합성 도구가 이를 논리 게이트의 연결로 바꾸고, 배치와 배선 단계가 그 결과를 실제 칩 위의 좌표와 금속층 배선으로 옮긴다. 탈라스는 모델에서 RTL로 내려가는 부분 자동화를 통해 이를 약 일주일치 엔지니어링 작업으로 줄였다고 한다. 설계 완료 후 파운드리에 제조 데이터를 넘기는 테이프아웃을 거쳐 동작하는 카드가 나오기까지 두 달을 목표로 한다고 밝혔다.16) 소프트웨어 배포 주기에 가까운 속도로 전용 칩을 반복 생산하겠다는 구상이다. 검증도 함께 풀어야 한다. 일반 칩은 오류가 발견되어도 소프트웨어나 펌웨어로 우회할 여지가 있지만, MSIC는 모델의 동작 자체가 회로이므로 설계에 오류가 있으면 칩 전체를 쓸 수 없다. 그런데 통상의 사인오프 항목은 이 오류를 잡아 주지 못한다. 설계 규칙 검사(DRC: design rule check)는 레이아웃이 공정 규칙을 지키는지 볼 뿐이어서, 마스크 ROM에 새겨진 가중치가 맞는 값인지는 애초에 검사 대상이 아니다. 도형이 규칙에 맞기만 하면 비아가 어느 자리에 있든 통과한다. 결국 테이프아웃 전에 모델 전체를 시뮬레이션하는 수밖에 없고, 이를 위해 탈라스는 대규모 컴퓨팅 클러스터에서 모델 전체와 다중 칩 구성까지 시뮬레이션하는 자체 작업 흐름을 구축했다. 3.4 레티클 한계와 프론티어 모델 마지막 과제는 규모다. 앞서 본 노광 한 번의 상한 858제곱밀리미터에 HC1의 815제곱밀리미터는 이미 근접해 있고, 그 안에 들어간 것은 80억 파라미터 모델이다. 1천억 파라미터를 넘는 모델은 한 다이에 담기지 않는다. 탈라스의 해법은 두 갈래다. 하나는 다이를 기능별로 쪼개는 것으로, HC2는 SRAM 부분을 별도 칩으로 분리해 가중치에 쓸 면적을 늘리고 칩당 약 200억 파라미터를 목표로 한다. 다른 하나는 모델의 층을 여러 카드에 나누어 순서대로 통과시키는 파이프라인 병렬이다. 층 단위로 자르면 카드 사이를 오가는 것이 활성값뿐이라 토큰당 수 킬로바이트에 그치므로, PCIe 수준 대역폭이면 충분하다는 주장은 무리가 없어 보인다. 탈라스가 제시한 것은 PCIe를 통신 수단으로 하는 보드와 카드 수준의 분산이다. 통신량이 작은 구간에서는 합리적인 선택이지만, 다이를 더 잘게 쪼개 밀도를 끌어올릴수록 결국 패키지 안의 배선 문제로 돌아온다. AMD가 인스팅트 계열에서 축적한 첨단 패키징 역량이 더해질 수 있는 지점이 여기다. 하지만 대규모 모델의 경우 사실상 한 모델을 위해 여러 각기 다른 칩을 생산해야 한다는 문제가 있다. 예를 들어, 딥시크 R1 671B 급에는 30장 이상이 필요한데, 이는 모델의 서로 다른 구간을 담은 30개 칩 설계이며 각각 별도의 테이프아웃을 요구한다.17) 1조 파라미터급은 HC2 기준 약 50장으로 추정된다. 여기에 최근 프론티어 모델이 향하는 MoE 구조는 이 방식에 맞지 않는다. GPU는 쓰이지 않는 전문가를 값싼 외부 메모리에 두면 되지만, MSIC에서는 쓰이지 않는 파라미터도 실리콘에 그대로 새겨져 있어야 하기 때문이다. 대규모 프론티어 모델은 아직 실물로 검증되지 않았다. 다중 칩 구성은 시뮬레이션을 통한 추정으로 보이며, 현재 가장 크게 남은 기술적 과제이자 상용화 리스크다. 815제곱밀리미터 대형 다이는 결함 하나에도 취약한데 앞서 보았듯 가중치는 여분으로 대체할 수 없어, 양산 불량률과 검사 비용이 수익성을 압박할 수 있다. 두 달 주기 역시 시제품 수준의 목표로 보는 것이 타당하다. 3.5 요약: 해결과제와 탈라스의 해법
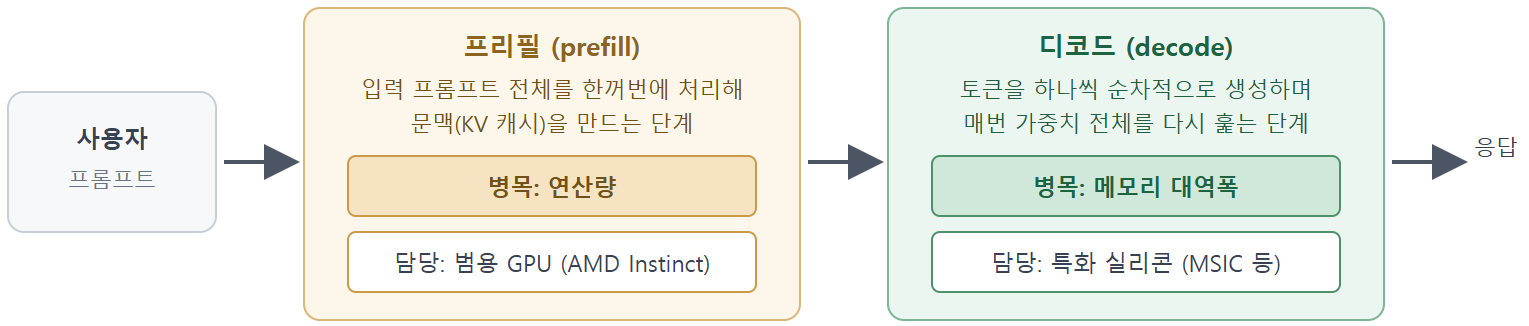
표 1 MSIC 구현을 위한 주요과제와 탈라스의 해법 4. AMD 인수의 의미 AMD가 인수한 것은 라마 8B 전용 칩 한 개가 아니다. 실제 자산은 세 가지의 결합이다. 첫째는 저장과 연산을 집적한 고밀도 패브릭 기술이다. 둘째는 임의의 모델로부터 자동으로 회로 설계와 마스크 패턴으로 변환하고 검증까지 마치는 설계 흐름이다. 셋째는 고정된 파운데이션 모델과 가변적인 KV 캐시, 어댑터를 결합하는 혼합 구조다. 이 셋이 함께 있어야 모델 특화 실리콘이 일회성 프로젝트가 아니라 반복 가능한 제품 플랫폼이 된다. 장기적으로는 두 번째 자산이 더 중요할 수 있다. 고객의 모델을 받아 맞춤 추론 실리콘으로 만들어 주는 사업이 성립한다면, AMD는 GPU 공급자를 넘어 모델 단위의 커스텀 칩 개발사로 영역을 넓힐 수 있다. AMD는 MSIC를 GPU의 대체재로 보지 않는다. 인수 발표에서 AMD AI 그룹 총괄 밤시 보파나(Vamsi Boppana)는 다양한 목적의 AI 워크로드에 최적화된 솔루션을 고객에게 제공할 수 있는 유연하게 활용할 수 있는 풀스택 플랫폼을 만들고 있다고 말했다. AMD는 탈라스의 기술을 자사 가속기 로드맵에 통합하고 인스팅트 GPU와 결합한 시스템 수준 해법을 개발하겠다고 밝혔다. 즉 대체가 아니라 역할 분담이라는 뜻이다. 이 결합은 실제 추론과정이 성질이 다른 두 단계로 나뉜다는 사실과 부합한다. 프리필(prefill)은 사용자가 넣은 프롬프트 전체를 한꺼번에 처리해 문맥을 만드는 단계이고 연산량이 병목이다. 디코드는 토큰을 하나씩 순차적으로 생성하는 단계이고 메모리 대역폭이 병목이다. 하나의 하드웨어로 두 단계를 모두 처리하면 어느 쪽에서든 자원이 남거나 모자란다. 그래서 단계를 물리적으로 분리해 각각에 맞는 하드웨어를 배정하는 분리 추론이 자연스러운 해법이 된다. AMD는 이미 이 구조를 실행에 옮긴 바 있다. 2026년 7월 세레브라스와 발표한 협력이 그것이다. 프롬프트를 받아 문맥을 만드는 프리필은 에픽(EPYC) CPU와 인스팅트 MI400 계열 GPU로 구성된 헬리오스(Helios) 랙이 맡고, 토큰을 하나씩 생성하는 디코드는 세레브라스의 웨이퍼 스케일 엔진이 맡는 구성이다. 연산량이 많은 단계는 범용 GPU에, 지연이 중요한 단계는 특화 실리콘에 배정한 셈이다. 두 시스템을 이렇게 나누어 쓰면 와트당 초당 토큰 수를 최대 5배까지 끌어올릴 수 있다는 것이 양사의 설명이다.18) 같은 자리에 탈라스의 MSIC를 넣는 것은 아키텍처 관점에서 자연스러운 접근이다. 인스팅트 GPU가 프롬프트 처리를 맡고 탈라스 실리콘이 토큰 생성을 맡는 분할 구성으로 헬리오스 랙에 배치하며, 전체를 ROCm 소프트웨어 스택으로 다룬다는 것이 AMD의 계획이다.19) <그림 4>는 이 구조를 도식화한 것이다. 그림 4 추론 단계별 하드웨어 분리 5. 향후 과제와 시사점 MSIC의 성립 조건은 하드웨어 수명과 모델 수명의 관계에 달려 있다. 칩을 설계하고 양산하는 데 걸리는 시간이 그 칩에 새겨진 모델이 상용으로 쓰이는 기간보다 짧아야 이 방식이 경제적으로 성립한다. 새 모델이 한 달 단위로 나오는 지금의 속도는 이 조건에 맞지 않는다. 반대로 특정 모델이 오래 안정적으로 대량 서비스되는 구간, 예를 들어 검증을 마친 특정 버전을 장기간 고정해 쓰는 제조산업 현장에서는 조건이 맞아떨어진다. 특히 여러 요청을 묶어 배치로 처리할 필요가 없는 온프레미스 추론이나 엣지 실행에서 모델 특화 실리콘의 의미가 크다. 다만 검증되지 않은 항목이 많다. 공개된 성능 수치는 대체로 회사가 제시한 시제품 기준이며 제3자 검증을 거치지 않았다. 3비트 수준의 양자화가 복잡한 과제를 해결할 때 품질을 얼마나 떨어뜨리는지, 대형 다이의 양산 수율이 수익성을 담보할 수 있는지, 두 달 테이프아웃이 양산 규모에서 안정적으로 유지될 수 있는지, 다중 칩으로 프론티어 모델을 실제로 돌릴 수 있는지 등 아직 남은 질문이 많다. AMD가 인수한 것은 완성된 제품이라기보다 팀과 방법론, POC에 가깝고, 이 접근이 GPU 이후 추론 경제학의 한 축이 될 가능성에 선제적으로 베팅한 성격이 강하다. AI 반도체 경쟁의 축이 범용 연산 성능에서 워크로드 특화 설계 역량으로 이동하고 있다. 탈라스의 진입 장벽은 트랜지스터 수준의 특화 기술 하나가 아니라 소자 기술과 설계 자동화, 검증, 파운드리 공정을 하나의 닫힌 고리로 엮은 데 있다. 이런 역량은 연산 성능 경쟁처럼 자본 규모가 결정하는 영역이 아니어서 국내 팹리스가 겨냥할 여지도 충분히 있다. 지난 수십 년간 컴퓨팅의 기본 전제는 하드웨어가 범용이고 소프트웨어가 그것을 특화한다는 것이었다. MSIC는 어떻게 보면 이 진화의 과정을 역행하는 것이다. 모델이 회로가 되고, 사람의 언어가 그 위의 소프트웨어가 된다. 이런 방식이 진짜 유효한 결과를 만들어 낼지는 결국 모델의 진화 속도가 실리콘의 제작 속도와 어떻게 균형을 유지하는가에 달려 있다. 참고문헌 1) AMD, “AMD Acquires Taalas to Advance Compute Solutions for Rapidly Growing AI Inference Market”, AMD Newsroom, Aug. 6, 2026 2) CNBC, “Nvidia buying AI chip startup Groq’s assets for about $20 billion in its largest deal on record”, Dec. 24, 2025 3) MSIC는 ASIC처럼 일반적으로 통용되는 용어는 아니며 또한 AMD나 탈라스가 사용하는 공식 명칭도 아니다. 다만, 본 기고문에서는 MSIC가 탈라스 기술의 핵심을 잘 드러내는 용어이기에 글 전반에 사용한다. 4) 실제로는 이보다 훨씬 간단하게 부호비트로 나머지 비트를 마스킹하는 AND 게이트로 구현된다. 5) 혼합 전문가(MoE) 구조에서는 토큰마다 일부 전문가만 활성화되므로 읽어야 할 가중치가 전체보다 훨씬 적다. 예를 들어 딥시크 R1은 6,710억 파라미터 가운데 370억 개만 쓰인다. 6) EE Times, "Taalas Specializes to Extremes for Extraordinary Token Speed", Feb. 19, 2026 7) HC1은 실제 3비트 기본에 일부 6비트를 섞은 자체 방식을 쓰지만 평균하면 4비트 안팎이 된다. 탈라스에서도 이방식의 추론품질이 낮음을 인정하며, HC2에서는 표준 FP4를 채택한다고 한다. 8) https://en.wikipedia.org/wiki/3_nm_process 9) 최신 상용 칩의 경우 이 한계를 극복하기 위해 2개 이상의 칩을 이어 붙이는 ‘칩렛’ 구조를 많이 쓴다. 10) The Next Platform, "Taalas Etches AI Models Onto Transistors To Rocket Boost Inference", Feb. 19, 2026 11) Zhao, Yongwei, “Taalas HC1 Architecture Decoded”, Mar 1, 2026 12) Taalas Inc., "Mask Programmable ROM Using Shared Connections", 특허번호 WO2025217724A1 13) Taalas Inc., "Computing Architecture with Model Core and Fine-Tuning Portion", 특허번호 US20250238726A1 14) Yiming Chen et al., "YOLoC: DeploY Large-Scale Neural Network by ROM-based Computing-in-Memory using ResiduaL Branch on a Chip", arXiv, Jun 1, 2022 15) EEJournal, "Redefining Structured ASIC", May 24, 2005 16) Taalas, "The path to ubiquitous AI" (https://taalas.com/the-path-to-ubiquitous-ai/) 17) Taalas, "The path to ubiquitous AI" (https://taalas.com/the-path-to-ubiquitous-ai/) 18) Tom's Hardware, "AMD and Cerebras partner on low-latency, high-throughput AI inference", Jul. 2026. 19) Forbes, "AMD Buys Taalas, The Startup That Carves AI Models Into Silicon", Aug. 9, 2026
이슈리포트_2026-08호.pdf (1 MB)
|
||||||||||||||||||||||||||