|
2026.09.30 (수정 : 2026.10.02)
|
|||||||||||||||||||||||||||||||||
|
04 AI 시대의 소프트웨어 엔지니어: 검증과 현장 중심의 역할 재편 │윤대균 아주대학교 소프트웨어학과
1. 들어가며 AI의 확산은 소프트웨어 개발에서 사람이 담당하는 작업의 범위를 바꾸고 있다. 깃허브의 2025년 보고서에 따르면 신규 가입 개발자의 약 80%가 첫 주에 코파일럿(Copilot)을 사용했다1). 자동완성과 대화형 보조에서 시작한 도구는 계획 수립, 여러 파일의 수정, 테스트와 재시도를 수행하는 코딩 에이전트로 확장되었다. 하지만, AI를 활용하여 완성된 산출물에 대해서 완전히 신뢰하고 있는 분위기는 아니다. 스택 오버플로의 2025년 개발자 설문에서 응답자의 84%는 AI 도구를 사용하거나 사용할 계획이라고 답했다. 그러나 정확성을 신뢰한다는 응답은 약 33%로, 신뢰하지 않는다는 응답 약 46%보다 낮았다. 같은 조사에서 가장 큰 불만은 성능이나 비용이 아니었다. “거의 맞지만 완전히 맞지는 않은” 답변을 응답자의 66%가 지목했다2). 이러한 간극이 소프트웨어 엔지니어의 역할을 어떻게 재정의하는 지를 다뤄 보고자 한다. 먼저 조직, 작업, 개인이라는 세 가지 다른 수준에서 관측된 데이터가 왜 하나의 결론으로 수렴하는지 정리하고 그 결론이 요구하는 작업 방식의 변화를 살펴본다. 마지막으로 최근 채용 시장에서 급부상한 포워드 디플로이드 엔지니어(FDE: forward deployed engineer)에 대해서도 살펴본다. 2. 구현 속도와 개발 성과의 간극 2.1 조직 수준: 검증 비용과 배포 안정성 코드 생성의 가속이 소프트웨어 배포 성과를 일관되게 개선하지는 않는다. 구글 클라우드의 2025년 데브옵스 연구 및 평가(DORA: DevOps Research and Assessment) 보고서에서는 약 5천 명의 기술 인력을 조사했으며, 응답자의 90%가 업무에 AI를 사용한다고 밝혔다. AI 도입은 소프트웨어 ‘배포 양’과 비례 관계를 보였지만, ‘배포 안정성’은 오히려 그 반대의 관계를 보였다3). 물론 그렇다고 해서 AI가 장애 증가의 직접적인 원인이라고 단정할 수는 없다. AI 활용의 순효과는 생성 시간과 검증 시간을 함께 측정해야 드러난다. 생성 단계에서 절약한 시간의 일부는 코드 리뷰, 테스트, 오류 수정에 투입된다. 스택 오버플로 설문에서도 응답자의 약 45%가 AI 생성 코드의 오류 수정에 시간이 더 든다고 답했다. 생산성은 이러한 검증 비용을 포함해 품질 기준을 충족하기 위해 코드를 수정하는 총소요 시간으로 판단해야 한다. 검증 비용을 관리하려면 기존 개발 체계의 완성도를 높여야 한다. DORA 보고서는 자동화된 테스트, 성숙한 버전 관리, 신속한 피드백과 모듈 간 의존성이 낮은 구조를 강조한다. AI는 이러한 기반을 갖춘 조직의 성과를 높일 수 있지만, 기반 구조와 절차가 취약할 경우 더 많은 위험 요소를 증폭할 수 있다. 검증 과정에서는 자동화 편향도 경계해야 한다. AI가 생성하는 설명과 코드가 겉으로 드러나는 완성도가 높더라도 실제 요구사항을 충족하는지는 별도로 확인해야 한다. 특히 AI가 구현과 테스트를 함께 생성하면 동일한 오해가 양쪽에 반영될 수 있다. 사람이 승인한 요구사항을 기준으로 테스트를 검토하고, 정상 동작 외에 실패 조건과 권한 경계도 확인해야 한다. 2.2 작업 수준: 시제품과 운영 소프트웨어의 차이 시제품을 빠르게 만드는 능력과 운영 가능한 소프트웨어를 완성하는 능력은 구분해야 한다. 소프트웨어 엔지니어 애디 오스마니(Addy Osmani)는 AI를 활용한 개발의 이러한 특성을 '70% 문제’로 설명했다. 초기 결과물은 70% 수준까지 빠르게 나오지만 운영 수준의 완성도를 확보하는 단계에서 어려움이 커진다는 것이다4). 여기서 ‘70%’는 실제 측정값이 아닌 설명을 위한 비유다. 운영 수준의 완성도는 예외 처리와 시스템 통합에서 결정된다. 빈 입력, 동시 요청, 네트워크 중단에 대응하고 인증과 접근 권한을 검증해야 한다. 기존 시스템과의 연동, 장애 복구, 성능과 운영 비용도 확인 대상이다. 정상 조건에서의 실행만으로 운영 적합성을 판단할 수는 없다. AI가 구현을 가속할수록 완료 기준을 구체화하는 일이 중요해진다. 기능별 성공 조건과 허용 가능한 실패 범위를 미리 정하고, 핵심 위험을 먼저 시험해야 한다. 예를 들어 예약 기능의 완료 여부는 예약 한 건의 성공뿐 아니라 중복 요청 처리와 취소 시 상태 복구까지 확인해 판단해야 한다. 2.3 개인 수준: 체감과 실측의 차이 개인이 체감하는 생산성과 실제 작업 시간은 다를 수 있다. 비영리 AI 평가기관 metr은 숙련된 오픈소스 개발자 16명이 참여하는 무작위 대조 시험(RCT: randomized controlled trial)을 수행했다. 참가자들이 익숙한 저장소의 실제 작업 246건을 AI 사용 허용 여부에 따라 무작위 배정한 결과, AI 허용 조건의 소요 시간은 19% 늘었다. 반면 참가자들은 실험 전에는 24% 단축을 예상했고, 종료 후에도 20% 단축되었다고 인식했다5). 체감과 실측의 차이가 약 40%나 되는 결과다. 물론 이 결과를 AI 무용론으로 읽는 것은 무리다. 표본이 16명이고 참가자들이 이미 익숙한 대형 코드베이스를 대상으로 실험한 제한된 조건임을 연구진 스스로 밝혔다. 이 결과가 다른 개발자나 낯선 코드베이스에까지 일반화되지는 않는다고도 명시했다. 이 실험에서 취해야 할 함의는 다른 데 있다. 약 40%에 이르는 인식 오차가 존재한다는 것은 개인의 체감을 생산성 판단 근거로 삼아서는 안 된다는 의미다. 어떤 작업에 위임이 이득이고 어떤 작업에 손해인지는 예상 시간과 실제 시간을 기록해 대조해야 드러난다. ‘느낌’을 데이터로 교정하는 ‘캘리브레이션(calibration)’이 필요한 이유다.
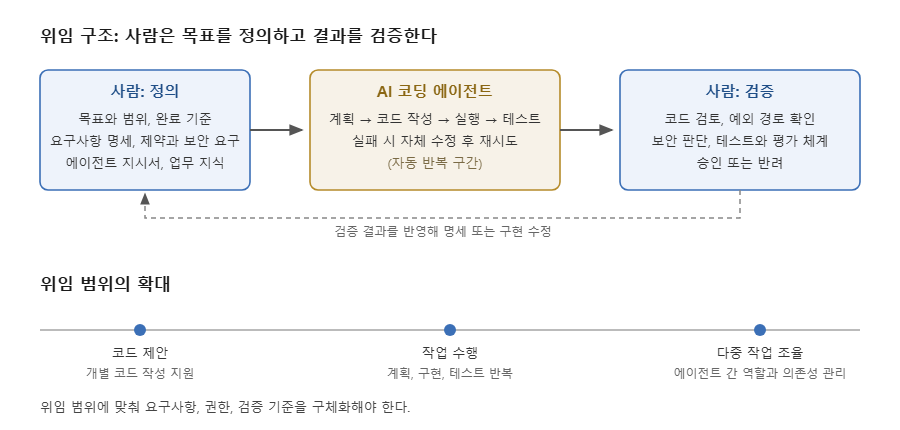
그림 1 위임 범위의 확대와 사람의 역할 개인과 팀의 판단은 작업 유형별 기록으로 보완해야 한다. 예상 시간과 실제 시간, 검토와 재작업에 든 시간, 완료 후 발견된 결함을 함께 비교하면 위임에 적합한 작업을 구분할 수 있다. 여러 에이전트를 동시에 사용한다면 사람의 투입 시간과 작업 완료까지의 경과 시간도 나누어 기록해야 한다. 그림은 위임 범위가 확대될 때 사람이 담당해야 할 ‘정의’와 ‘검증’의 관계를 보여준다. 3. 검증의 기반: 명세와 작업 맥락의 관리 3.1 명세 주도 개발 검증의 출발점은 기대하는 동작과 제약을 명시하는 데 있다. 자연어로 코드를 생성하되 세부 코드 검토보다 실행 결과에 큰 비중을 두는 '바이브 코딩'은 문제/솔루션 탐색과 시제품 개발에 유용하다. 운영 소프트웨어에는 요구사항과 변경 이력, 인수 기준이 추가로 필요하다. 안드레이 카파시도 자신의 앱 개발 경험에서 초기 화면 구현 이후 인증, 결제, 배포와 외부 서비스 연결에 상당한 작업이 필요했다고 설명했다6). 명세 주도 개발(SDD: spec-driven development)은 명세를 사람과 AI가 공유하는 구현 기준으로 삼는다. 소프트웨어 컨설팅 기업 소트웍스(Thoughtworks)의 비르기타 뵈켈러(Birgitta Böckeler)는 이를 "AI로 코드를 쓰기 전에 스펙을 먼저 쓰는 것, 그리고 그 스펙이 사람과 AI 모두에게 진실의 원천이 되는 것"으로 정의한다7). 핵심은 요구사항과 제약, 설계 결정을 모두 버전 관리하고 구현 및 검증 과정에서 일관되게 참조하는 것이다. 제대로 된 명세라면 요구사항을 관찰 가능한 인수 기준과 연결시킬 수 있어야 한다. 목적과 범위, 주요 용어, 입력과 출력, 실패 조건, 보안과 성능 요구사항을 포함하되 실제 구현에 필요한 수준으로 상세하게 작성한다. 예를 들어 예약 기능이라면 같은 요청을 반복했을 때의 처리 방식, 사용자별 접근 범위, 취소와 환불의 조건을 명확히 해야 한다. 이러한 기준을 테스트 항목에 연결하면 명세와 코드 사이의 불일치를 추적할 수 있다. 명세는 작은 변경 단위로 작성하고 검증된 요구의 변화에 맞춰 갱신해야 한다. 뵈켈러는 과도한 사전 문서화와 AI의 불완전한 지시 이행이 오히려 검토 부담을 늘릴 수 있다고 지적한다. 요구가 불명확한 초기에는 시제품으로 가설을 검증하고, 확인된 내용을 반복하여 명세에 반영하는 방식이 적합하다. 문서의 분량보다 요구사항, 코드, 테스트 사이의 일치가 중요하다. 3.2 지시문 작성에서 작업 맥락 설계로 질문을 잘 쓰는 기술은 환경을 잘 설계하는 기술로 확장되었다. 앤트로픽은 컨텍스트 엔지니어링을 모델이 추론에 필요로 하는 정보를 선별하고 유지하는 전략으로 설명한다8). 지시문 작성에 초점을 둔 프롬프트 엔지니어링에 더해 명세, 업무 지식, 코드 구조, 도구의 실행 결과와 대화 이력을 함께 관리하는 접근이다. 작업 맥락의 품질은 정보량보다 관련 문서/데이터 간 상호 관련성과 일관성에 달려 있다. 오래된 설계 문서나 서로 충돌하는 지시를 함께 제공하면 잘못된 구현으로 이어질 수 있다. 문서별 적용 범위와 우선순위, 최신 버전을 명시하고 현재 작업에 필요한 정보만 제공해야 한다. 긴 작업에서는 주요 결정과 미해결 문제를 별도로 기록한다. 서면 명세를 작성하는 능력은 엔지니어링의 핵심 역량이다. 요구사항을 구현 가능한 조건으로 바꾸려면 용어와 상태, 예외와 책임 범위를 구분해야 한다. 대화에서 합의한 내용을 명세와 구조화된 결정 기록으로 정리하면 사람과 에이전트가 동일한 기준으로 작업할 수 있다.
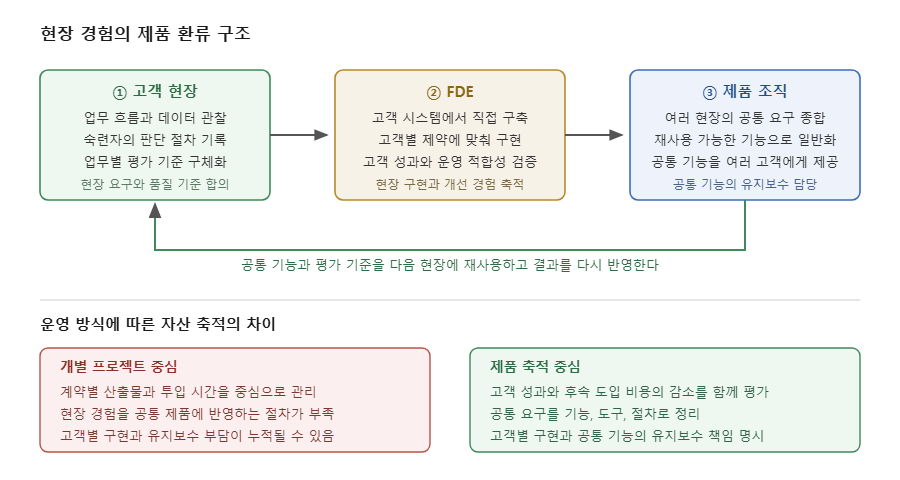
표 1 AI 활용 확대에 따른 역량의 강조점 기초 지식은 AI 산출물을 평가하기 위해 반드시 필요하다. 자료구조와 알고리즘, 운영체제와 네트워크의 원리를 이해해야 성능 저하와 오류의 원인을 설명할 수 있다. PBL(Problem Based Learning)에 기반한 교육에서도 결과물의 실행 여부와 함께 구현 원리, 검증 근거와 수정 과정을 평가하는 것이 바람직하다. 4. 현장 중심 개발과 FDE 4.1 팔란티어 모델의 핵심 FDE는 고객의 업무 현장에서 문제를 정의하고 소프트웨어를 구현하는 역할이다. 팔란티어의 공식 설명에 따르면 일반 제품 개발자가 여러 고객에게 제공할 공통 기능에 집중하는데 비해, fde는 한 고객의 문제를 해결하도록 여러 기능을 구성한다9). 따라서 현장은 단순한 최종 제품의 설치 장소가 아니라 요구사항과 품질 기준을 발견하는 공간이 된다. 팔란티어 모델의 특징은 현장 경험을 공통 제품으로 전환하는 역할 분담에 있다. 이 회사에서 8년간 근무한 나빌 쿠레시(Nabeel Qureshi)는 FDE가 고객별 문제를 해결하고 제품 개발 조직이 그 해법을 일반화했다고 회고한다. 현장에서 반복되던 데이터 수집과 시각화 작업은 파운드리의 공통 도구로 발전했다10). 현장 밀착은 문서에 드러나지 않는 업무 제약을 파악하는 데 유효하다. 쿠레시는 에어버스의 항공기 생산 현장에서 작업 지시, 부품 부족, 품질 문제를 연결하는 소프트웨어를 개발한 경험을 소개한다. 이러한 작업에는 데이터 구조뿐 아니라 현장 구성원의 판단과 협업 방식에 대한 이해가 필요하다.
그림 2 현장 경험의 제품 환류 구조 4.2 AI 제품에서 현장 접점이 중요한 이유 AI 제품의 품질은 일반 성능 지표와 고객 업무의 요구조건을 함께 평가해야 한다. AI로 코드를 개발하는 일과 AI를 제품 기능으로 운영하는 일은 구분되지만, 두 경우 모두 목적에 맞는 검증 기준이 필요하다. 특히 AI 제품에서는 업무상 허용되는 오류와 사람이 개입해야 하는 조건을 현장 담당자와 합의해야 한다. 업무 평가 체계는 실제 사례와 실패 조건을 중심으로 구성해야 한다. 예를 들어 설비 이상 진단을 지원하는 AI라면 최종 판단의 정확성에 더해 근거 자료의 적절성, 필요한 확인 절차의 이행, 잘못된 조치의 방지 여부를 평가할 수 있다. 숙련자의 판단을 참고하되 특정 작업 순서를 유일한 정답으로 고정하지 않고, 결과와 필수 제약을 구분해야 한다. FDE는 이러한 평가 기준을 업무 전문가와 공동으로 정의하고 운영 결과로 보완한다. 주요 AI 기업의 채용 공고는 이 역할이 엔지니어링임을 명시하고 있다. 오픈AI는 시제품부터 안정적인 운영까지의 기술적 실행과 함께, 효과적인 구현 방식을 다른 사람이 사용할 도구와 절차로 정리하는 것을 fde 역할로 명시하고 있다11). 앤트로픽도 고객 시스템 내부의 운영 애플리케이션 구축, 반복 가능한 배포 방식의 정리, 제품 및 엔지니어링 조직으로의 의견 전달을 명시한다12). 기업의 투자 방향에서도 현장 도입 역량의 중요성을 확인할 수 있다. 오픈AI는 2026년 5월 기업의 AI 도입을 지원하는 별도 회사 설립을 발표하면서 40억 달러를 초과하는 초기 투자 계획을 밝혔다. 또한 인수 계약을 체결한 토모로(Tomoro)를 통해 FDE와 배포 전문가 약 150명을 확보할 계획이라고 설명했다13). 이는 모델 제공과 함께 고객의 시스템 및 업무에 통합하는 역량을 확충하려는 움직임으로 해석할 수 있다. 4.3 FDE 직군의 정체성 FDE와 인접 직군의 차이는 직함만으로 구분하기 어렵다. 컨설팅 기업도 소프트웨어를 구현하고 재사용 자산을 축적하며, 솔루션 아키텍트도 고객의 설계와 운영에 관여할 수 있다. 소프트웨어 제품 분야에서 오래 활동해 온 토마스 오터는 FDE라는 명칭이 기존 구축이나 영업 지원 직무를 재포장하는 데 사용될 수 있다고 비판한다14). 실제 책임과 성과 지표를 제대로 확인해야 한다는 지적이다. 제품 관점의 FDE는 고객의 성과와 공통 제품의 개선을 연결한다. 마티 케이건은 현장에 참여한 엔지니어가 문제와 해결 조건을 이해하고, 제품 조직은 여러 현장에서 얻은 학습을 종합해 공통 기능으로 발전시켜야 한다고 설명한다15).
표 2 인접 직군과 FDE 비교 조직마다 직무의 범위가 다르므로 표 2는 상호 배타적인 분류가 아니다. 구체적으로는 고객 시스템에서의 구현 책임, 업무 성과에 대한 책임, 공통 제품에 반영하는 절차가 어디에 배정되는지를 확인해야 한다. 시간 단위 과금이나 고객전용 개발의 유무만으로 직군을 판정할 수는 없다. 현장의 학습을 제품에 반영하려면 담당 조직과 절차를 명확히 해야 한다. 현장 팀은 검증된 요구와 구현 경험을 전달하고, 제품 팀은 재사용 가능성과 유지보수 비용을 평가해 공통 기능으로 반영한다. 고객별 확장과 공통 기능의 경계를 정하고, 임시 구현의 정비 책임도 합의해야 한다. 성과는 제품 반영 건수뿐 아니라 고객의 업무 개선과 후속 도입 비용의 감소를 함께 보아야 한다. 5. 향후 과제와 시사점 AI로 인해 주니어 개발자의 자리가 사라진다는 주장을 단정적으로 받아드리기는 어렵지만 이러한 신호는 꾸준히 나타나고 있다. 스탠퍼드 대학교 디지털경제연구소는 미국 급여 자료를 분석해, 2026년 6월 AI 노출도가 높은 직군의 22~25세 고용이 노출도가 낮은 직군보다 19% 낮다고 보고했다. 조정은 주로 채용 감소에서 나타났다16). 다만 이는 인과적 효과의 추정이 아니며 교육 수준, 표본 구성과 분석 방법에 따른 한계가 있다고 연구진은 밝혔다. 이를 국내 초급 개발자의 고용 전망에 그대로 적용해서는 안 된다. 국내에서는 AI 활용 능력을 채용 기준에 반영하려는 움직임이 나타난다. 카카오는 2025년 9월 첫 그룹 단위 전 직군 신입 공개채용에서 AI 기술로 새로운 가치를 창출하는 인재를 선발하겠다고 밝혔다17). 잡코리아 분석에 따르면 2026년 1분기 기준 AI 키워드를 포함한 공고는 5년 전 대비 112% 늘었고 신입 대상 AI 공고는 162% 증가했다. 조직은 AI 도입 효과를 품질과 운영 성과까지 포함해 평가해야 한다. 자동화된 테스트와 명시적인 완료 기준을 도구 도입과 함께 마련하고, 변경 완료 시간, 재작업, 운영 중 결함을 지속적으로 관찰해야 한다. 초기에는 범위가 작고 결과를 확인하기 쉬운 작업에서 시작해 측정 결과에 따라 위임 범위를 확대하는 방식이 적합하다. 개인은 구현 능력에 문제 정의와 검증 역량을 결합해야 한다. 업무 담당자와 요구사항을 구체화하고, AI에 맡길 작업과 직접 판단할 부분을 나누며, 결과의 적절성을 설명할 수 있어야 한다. 초급 개발자에게도 이러한 경험을 제공하되 숙련자의 검토와 피드백을 통해 책임 범위를 점진적으로 넓혀야 한다. 이제 교육의 과제는 기초 역량, AI 활용, 업무 이해를 함께 발전시키는 것이다. 이를 소프트웨어 교육에 적용하면 실제 사용자의 문제를 조사하고 명세, 구현, 검증을 반복하는 과제가 적합하다. 학습자는 생성한 코드를 설명하고 오류의 원인과 수정 근거를 제시할 수 있어야 한다. 앤드루 응은 소규모 AI 활용 팀에서 제너럴리스트가 유리해지는 이유를 이렇게 설명했다. “두 사람으로 구성된 팀이 다섯 가지 전문성이 필요한 일을 해내야 한다면, 그중 누군가는 자기 전문 영역 밖의 역할을 맡아야 한다.” 그는 일부 팀에서 엔지니어와 제품 관리자의 비율이 8대 1에서 1대 1까지 내려가고 있다고 관찰한다18). 구현 비용이 떨어질수록 차별화는 무엇을 만들지 결정하는 능력과 만든 것이 맞는지 판정하는 능력에서 나온다. 소프트웨어 엔지니어가 가야 할 방향도 여기에 있다. 참고문헌 1) GitHub, “Octoverse 2025: A new developer joins GitHub every second as AI leads TypeScript to #1”, Oct. 2025. 2) Stack Overflow, “2025 Developer Survey: AI”, 2025. 3) Google Cloud, “Announcing the 2025 DORA Report”, Sep. 2025. 4) Addy Osmani, “The 70% problem: Hard truths about AI-assisted coding”, Dec. 2024. 5) METR, “Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity”, Jul. 2025. 6) Andrej Karpathy, “Vibe coding MenuGen”, Apr. 27, 2025. 7) Birgitta Bockeler, “Understanding Spec-Driven-Development: Kiro, spec-kit, and Tessl”, martinfowler.com, Oct. 2025. 8) Anthropic, “Effective Context Engineering for AI Agents”, Sep. 2025. 9) Palantir, “A Day in the Life of a Palantir Forward Deployed Software Engineer”, Nov. 2020. 10) Nabeel S. Qureshi, “Reflections on Palantir”, Oct. 2024. 11) OpenAI, “Forward Deployed Engineer (FDE), San Francisco” 채용 공고, 12) Anthropic, “Forward Deployed Engineer, Applied AI” 채용 공고. 13) OpenAI, “OpenAI launches the Deployment Company”, May 2026. 14) Thomas Otter, “On the Forward Deployed Engineer”, Dec. 2025. 15) Marty Cagan, “Forward Deployed Engineers”, SVPG, Sep. 2025. 16) Stanford Digital Economy Lab, “No Widespread Displacement, but the AI Employment Gap for Young Workers Has Widened to 19%”, Aug. 12, 2026. 17) 카카오, “카카오, 창사 첫 그룹 통합 신입 공개채용 실시”, 2025.9.3. 18) Andrew Ng, “AI-Native Software Development Needs Generalists”, The Batch, Apr. 2026.
이슈리포트_2026-09호.pdf (1 MB)
|
|||||||||||||||||||||||||||||||||